98 Prozent. 99,9 Prozent. 100 Prozent. Die Benchmark-Werte der neuesten KI-Modelle klingen nach gelöster Aufgabe – und sagen über deinen Arbeitsalltag fast nichts aus. Nicht weil sie gefälscht wären, sondern weil ein Test, den alle bestehen, nichts mehr misst. Hier steht, was hinter den Zahlen steckt, warum Anbieter sie trotzdem zeigen und woran du stattdessen entscheiden solltest. Stand: 10. September 2026.
Warum 100 Prozent ein schlechtes Zeichen sind
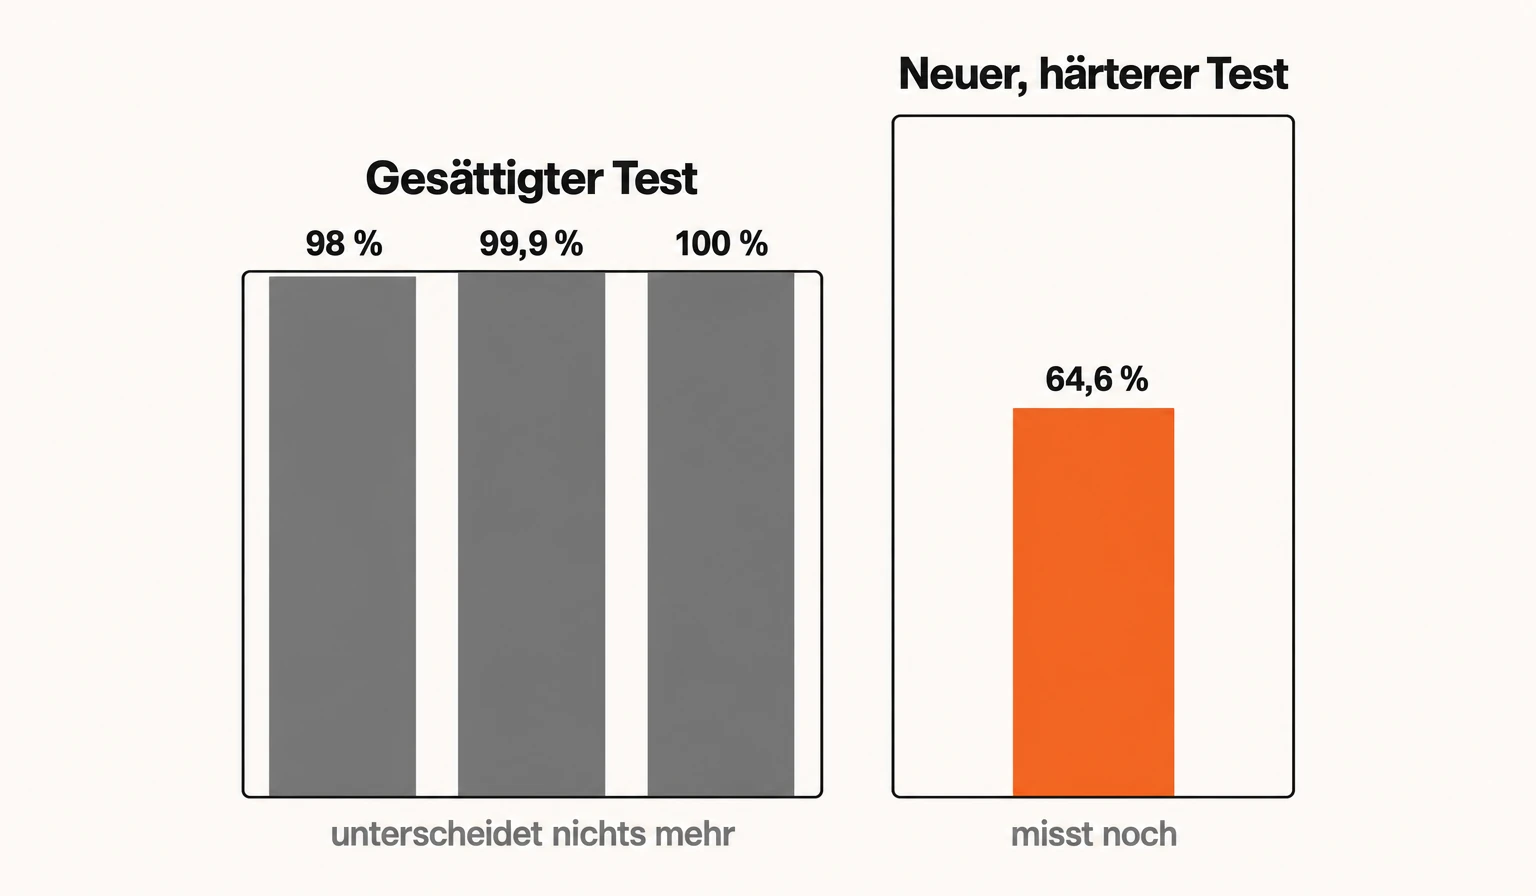
Ein Benchmark ist eine Sammlung von Aufgaben mit bekannten Lösungen. Solange Modelle daran scheitern, unterscheidet er – man sieht, wer besser ist. Sobald mehrere Modelle nahe an die Obergrenze kommen, unterscheidet er nichts mehr. Fachleute nennen das Sättigung, und die Anbieter benutzen das Wort selbst.
Die Grafik oben zeigt es: Die Balken stoßen an die Decke des Rahmens. Ob ein Modell dahinter noch besser wäre, kann der Test nicht mehr zeigen – man braucht einen neuen, härteren Rahmen. Genau deshalb tragen aktuelle Tests Namen mit Stufen und Versionsnummern: FrontierMath Tier 4, ARC-AGI-3, Terminal-Bench 4.0. Jede Zahl im Namen ist eine gesättigte Vorgängerversion.
„Das Modell hat 100 Prozent auf einem Sicherheits-Benchmark – also ist es sicher.“ Falsch. Es heißt: Dieser Test kann dieses Modell nicht mehr fordern. Über Aufgaben, die im Test nicht vorkommen, sagt das Ergebnis nichts. Ein bestandener Führerschein macht niemanden zum Rennfahrer.
Die oberen drei Balken sind praktisch gleich lang – der Test unterscheidet zwischen Spitzenmodellen nicht mehr, er ist gesättigt. Nur die unteren beiden trennen überhaupt noch. Und Prozentpunkte täuschen am oberen Ende: von 96 auf 98 Prozent halbiert sich die Fehlerquote, von 60 auf 62 sinkt sie um 5 Prozent – derselbe Abstand, völlig andere Aussage.
Die beiden unteren Balken sind die einzigen, die etwas mitteilen, und sie sind die unspektakulärsten. Genau darin liegt das Muster: Je beeindruckender eine Prozentzahl aussieht, desto weniger unterscheidet der Test dahinter.
Dazu kommt ein Rechenfehler, den fast jede Meldung macht. Prozentpunkte täuschen am oberen Ende. Steigt ein Wert von 96 auf 98 Prozent, klingt das nach zwei mageren Punkten – tatsächlich halbiert sich die Fehlerquote von 4 auf 2 Prozent. Derselbe Abstand von 60 auf 62 Prozent senkt die Fehlerquote dagegen nur von 40 auf 38, also um 5 Prozent. Wer Modelle vergleicht, sollte deshalb nicht auf den Abstand der Trefferquoten schauen, sondern auf das Verhältnis der Fehlerquoten. Bei 98 gegen 96 Prozent ist ein Modell doppelt so gut wie das andere, bei 62 gegen 60 kaum besser.
Vier Gründe, warum die Zahlen wenig über deinen Alltag sagen
1. Sie stammen fast immer vom Anbieter. Modell, Testaufbau, Auswertung und Veröffentlichung liegen in einer Hand. Das muss nicht unredlich sein, aber es ist keine unabhängige Prüfung – und die Wahl, welche Tests gezeigt werden, gehört zur Erzählung.
2. Der Testaufbau verändert das Ergebnis. Wie viele Versuche sind erlaubt? Welche Werkzeuge darf das Modell nutzen? Wie viel Denkaufwand wurde eingestellt? Dieselbe Aufgabe liefert je nach Rahmen völlig verschiedene Werte. Wenn eine Angabe wie „unter unserem Prüfaufbau“ dabeisteht, ist das kein Kleingedrucktes, sondern die halbe Information.
3. Aufgaben können ins Training gelangen. Öffentliche Testaufgaben landen irgendwann in Trainingsdaten. Was dann gemessen wird, ist teilweise Erinnerung statt Können. Deshalb halten seriöse Benchmarks Teile ihrer Aufgaben zurück.
4. Sie messen selten deine Aufgabe. Wettbewerbsmathematik, Programmierwettbewerbe und Terminal-Aufgaben sind schwer – aber sie sehen anders aus als ein Angebot schreiben, einen Bescheid auswerten oder einen Kundeneinwand beantworten.
Wie du eine Benchmark-Meldung richtig liest
| Was dasteht | Was du prüfen solltest |
|---|---|
| „Neuer Bestwert von 98 %“ | Wie hoch war der Vorgänger? Ein Sprung von 96 auf 98 ist etwas anderes als von 60 auf 98 |
| „Sättigt den Benchmark“ | Der Test ist am Ende – vergleichbar sind die Modelle darüber nicht mehr |
| „Unter unserem Prüfaufbau“ | Andere Rahmenbedingungen ergeben andere Zahlen |
| „Bei geringeren Kosten“ | Geschätzt oder gemessen? Auf welcher Einstellung des Denkaufwands? |
| „Schlägt Modell X“ | Welche Version von X, mit welchen Einstellungen, wann getestet? |
Die Preis-Leistungs-Angaben sind dabei die rutschigsten. Wenn ein Anbieter einen Wert „bei rund 31 Prozent geringeren geschätzten Kosten“ nennt, steckt in „geschätzt“ die entscheidende Unsicherheit – die tatsächlichen Kosten hängen an Denkaufwand, Cache-Nutzung und Antwortlänge. Wie sich das rechnet, steht in den Guides zu Claude Fable 5.1 und GPT-6 Astra.
Der Benchmark, der für dich zählt
Er dauert einen Nachmittag und schlägt jede Tabelle:
- Sammle zehn echte Aufgaben aus deiner letzten Arbeitswoche. Keine Testfragen, keine Rätsel. Genau die Dinge, für die du das Werkzeug einsetzen willst – mit den echten Dokumenten und dem echten Kontext.
- Schreib vorher auf, was ein gutes Ergebnis wäre. Zwei Sätze je Aufgabe. Ohne diesen Schritt bewertest du hinterher das, was du bekommen hast, statt das, was du brauchtest.
- Gib allen Kandidaten wörtlich denselben Auftrag. Sonst vergleichst du deine Prompts statt der Modelle.
- Miss die Nacharbeit, nicht den Eindruck. Minuten bis zur Verwendbarkeit. Das ist die einzige Zahl, die im Alltag zählt – und sie korreliert erstaunlich schlecht mit Benchmark-Rängen.
- Zähl die Fälle, in denen etwas erfunden wurde. Für jede Aufgabe, bei der Zahlen, Namen oder Quellen vorkommen.
„Wie viele Minuten brauche ich, bis ich das Ergebnis verwenden kann – und wie oft musste ich etwas korrigieren, das falsch war?“
Zwei Zahlen, die dir mehr sagen als jede Benchmark-Tabelle. Sie beziehen sich auf deine Arbeit, nicht auf Wettbewerbsmathematik.Häufige Fragen
Was ist ein KI-Benchmark?
Eine Sammlung von Aufgaben mit bekannten Lösungen, mit der die Leistung von Modellen gemessen und verglichen wird. Bekannte Beispiele betreffen Mathematik, Programmierung, Computernutzung und Sicherheit.
Was bedeutet, dass ein Benchmark gesättigt ist?
Dass Modelle so nah an die Obergrenze kommen, dass der Test nicht mehr zwischen ihnen unterscheidet. Ein Wert von 99 oder 100 Prozent heißt deshalb nicht, dass ein Modell alles kann, sondern dass dieser Test es nicht mehr fordert.
Sind Benchmark-Ergebnisse von Anbietern vertrauenswürdig?
Sie sind meist nicht gefälscht, aber auch nicht unabhängig: Modell, Testaufbau und Veröffentlichung liegen in einer Hand, und die Auswahl der gezeigten Tests gehört zur Darstellung. Angaben zum eigenen Prüfaufbau sind ein wichtiger Hinweis.
Warum schneiden Modelle im Test besser ab als in meiner Praxis?
Weil Testaufgaben anders aussehen als Arbeitsaufgaben, weil der Testaufbau optimiert ist und weil Teile öffentlicher Testaufgaben in Trainingsdaten gelangen können. Gemessen wird dann teilweise Erinnerung statt Können.
Woran soll ich ein Modell stattdessen messen?
An zehn echten Aufgaben aus der eigenen Arbeitswoche, mit vorher definierten Erwartungen und identischem Auftrag für alle Kandidaten. Die beiden Kennzahlen: Minuten bis zur Verwendbarkeit und Zahl der Fälle, in denen etwas erfunden wurde.
Was sagen Preis-Leistungs-Angaben in Ankündigungen aus?
Wenig, wenn die Kosten geschätzt sind. Die tatsächlichen Kosten hängen an eingestelltem Denkaufwand, Cache-Nutzung und Antwortlänge – Faktoren, die je nach Anwendung stark schwanken.
Selbst bewerten statt Ranglisten glauben
Wer zehn eigene Aufgaben sauber testen kann, braucht keine Benchmark-Tabelle mehr. Genau diese Bewertungskompetenz bauen wir in unserer geförderten Weiterbildung auf – an Aufgaben aus deinem Berufsfeld. Ob eine Förderung in Betracht kommt, klären wir im kostenlosen Erstgespräch; entschieden wird sie von der Agentur für Arbeit.
Kostenloses Erstgespräch sichern
Benedikt Backhaus – schreibt bei Scaly über KI-Tools, neue Modelle und aktuelle Entwicklungen rund um künstliche Intelligenz. Preise und Funktionsangaben prüft er an den Seiten der Anbieter, nicht an Vergleichsportalen – Stand jeweils im Text. Einschätzung, keine Rechtsberatung. Benedikt auf LinkedIn