Dein Unternehmen hat hunderte Dokumente – Handbücher, Verträge, Prozessbeschreibungen, das Wiki – und die KI kennt keines davon. RAG (Retrieval-Augmented Generation) löst genau das: Statt Wissen ins Modell einzutrainieren, schlägt die KI vor jeder Antwort in deinen Unterlagen nach und antwortet daraus – mit Quellenangabe. Das ist 2026 der Standard-Weg, KI mit eigenen Daten arbeiten zu lassen; NotebookLM, Microsoft Copilot und die meisten Firmen-Chatbots funktionieren so. Dieser Artikel – Stand: September 2026 – erklärt das Prinzip ohne Buzzwords, zeigt vier Wege zur Umsetzung vom fertigen Produkt bis zum Eigenbau und benennt die Grenzen, die im Verkaufsgespräch selten vorkommen.
Das Problem: Die KI kennt dein Unternehmen nicht
Eine Mitarbeiterin fragt einen Chatbot: „Wie hoch ist bei uns die Übernachtungspauschale auf Dienstreisen?“ Die Antwort klingt souverän – und stammt aus dem Nichts, denn die Reisekostenrichtlinie deines Betriebs war nie Teil des Trainings. Sprachmodelle lernen aus öffentlich verfügbarem Text bis zu einem Stichtag; interne Handbücher, Verträge und Wikis kommen darin nicht vor.
Lange gab es zwei Auswege, beide unbefriedigend. Nachtrainieren: teuer, aufwendig – und bei der nächsten Richtlinien-Änderung wieder fällig. Dokumente in den Chat kopieren: funktioniert für ein PDF, aber nicht für eine Ablage mit tausend Dateien – welche davon soll die KI denn lesen? Genau in diese Lücke stößt RAG.
Die RAG-Idee: erst nachschlagen, dann antworten
Stell dir einen guten Bibliothekar vor. Du stellst eine Frage – und er liest dir nicht aus dem Gedächtnis vor, sondern geht ins Regal, sucht die drei passenden Seiten heraus, legt sie neben deine Frage und antwortet daraus. Mit Beleg: „Steht in Band 7, Seite 212.“ Nichts anderes macht RAG, in drei Schritten: Abrufen (die zur Frage passenden Textstellen aus der Wissensbasis heraussuchen), Anreichern (diese Fundstellen wandern zusammen mit der Frage ans Sprachmodell), Antworten (das Modell formuliert aus den mitgelieferten Stellen – idealerweise mit Quellenangabe).
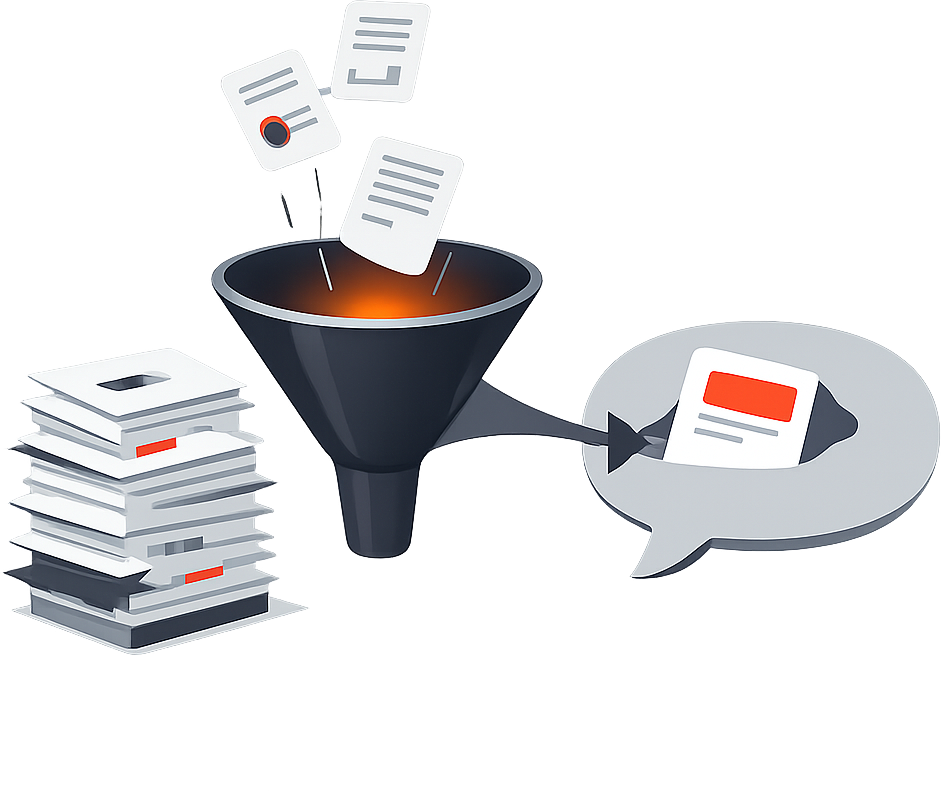
Damit das Heraussuchen funktioniert, werden die Dokumente vorab in Abschnitte zerlegt und so abgelegt, dass sich nach Bedeutung suchen lässt statt nur nach Stichworten – die Frage nach „freien Tagen“ findet auch den Absatz zum „Urlaubsanspruch“. Entscheidend ist, was dabei nicht passiert: Das Modell selbst bleibt unverändert. Es wird nicht schlauer über deine Firma – es bekommt nur besseren Lesestoff. Der Begriff stammt übrigens aus einer Forschungsarbeit von 2020; die Idee ist älter als der ChatGPT-Boom.
Warum RAG der Standard-Weg wurde
1. Aktueller als jedes Training. Ändert sich die Richtlinie, tauschst du das Dokument aus – die nächste Antwort nutzt die neue Fassung. Ein nachtrainiertes Modell wüsste bis zum nächsten teuren Trainingslauf nichts davon.
2. Deutlich günstiger. RAG nutzt vorhandene Modelle unverändert; bezahlt wird die Suche, nicht ein eigenes Modell. Für die allermeisten Betriebe ist das der Unterschied zwischen „machbar“ und „Konzernprojekt“.
3. Nachvollziehbar. Die Quellenangabe macht aus Glauben Prüfen: Du siehst, aus welchem Dokument die Antwort stammt, und kannst die Stelle nachlesen. Für alles, was Konsequenzen hat – Verträge, Richtlinien, Kundenauskünfte, ist das der eigentliche Kaufgrund.
4. Berechtigungen bleiben durchsetzbar. Weil das Wissen nicht im Modell steckt, sondern erst im Moment der Frage geholt wird, kann das System pro Person filtern. Microsoft formuliert das für seinen Copilot so:
„Microsoft Copilot zeigt nur Unternehmensdaten an, auf die einzelne Nutzer mindestens Lese-Zugriff haben.“
Microsoft-Dokumentation zu Copilot (übersetzt) – bei eintrainiertem Wissen wäre so eine Trennung unmöglich: Was ein Modell gelernt hat, kann es jedem erzählenVier Stufen: vom fertigen Produkt zum Eigenbau
„Wir brauchen RAG“ heißt nicht „wir müssen etwas bauen“. Es gibt eine Leiter – und die meisten kommen mit den unteren Sprossen aus:
| Stufe | Beispiele | Aufwand | Für wen |
|---|---|---|---|
| Fertiges Produkt | NotebookLM (heute Gemini Notebook) | Minuten – Dokumente hochladen, fragen; kostenlos startbar | Einzelpersonen und kleine Teams |
| Bordmittel der Plattform | Microsoft Copilot mit SharePoint-/Graph-Anbindung | Vorhandene Lizenz plus aufgeräumte Ablage | Betriebe, die ohnehin in Microsoft 365 arbeiten |
| Baukasten | Copilot Studio mit Wissensquellen, vergleichbare Agent-Baukästen | Tage Konfiguration, kein Programmieren | Fachabteilungen mit eigenem Assistenten für einen Prozess |
| Eigenbau | Open-Source-Bausteine wie LangChain oder LlamaIndex, lokale Stacks | Entwicklerprojekt inklusive Wartung | Besondere Anforderungen: Datenhoheit, Spezialformate, tiefe Integration |
Stufe 1 ist der schnellste Realitätstest: NotebookLM antwortet ausschließlich aus deinen hochgeladenen Quellen und verlinkt jede Aussage bis zur Fundstelle – ein RAG-Produkt in Reinform, ohne dass du das Wort je benutzen musst. Stufe 2 steckt in vielen Betrieben schon in der Lizenz: Microsoft Copilot beantwortet Fragen aus Mails, Chats und SharePoint-Dokumenten – mit den Rechten des jeweiligen Nutzers. Stufe 3 baut daraus gezielte Assistenten: In Copilot Studio legst du per Klick fest, aus welchen Wissensquellen – SharePoint, hochgeladene Dokumente, Websites – ein Agent antworten darf. Stufe 4 lohnt erst, wenn eine Stufe darunter nachweislich nicht reicht – etwa weil Daten das Haus nicht verlassen dürfen; dann lässt sich RAG auch komplett lokal auf eigener Hardware betreiben.
Die ehrlichen Grenzen
Weniger Halluzination heißt nicht null. Der Quellenzwang senkt das Risiko erfundener Antworten deutlich – beseitigt es aber nicht. Ein Forschungsteam der Stanford University hat 2024 kommerzielle juristische Recherche-Tools mit RAG-Technik getestet: Je nach Anbieter war mehr als jede sechste bis mehr als jede dritte Antwort fehlerhaft – trotz Quellenbindung.
„Wir zeigen, dass in der Praxis auch RAG-Systeme nicht frei von Halluzinationen sind.“
Stanford-Studie zu juristischen KI-Recherche-Tools, 2024 (übersetzt) – auch die Suche selbst kann danebengreifen und dem Modell unpassende Fundstellen unterschiebenGarbage in, garbage out. Liegt in der Ablage die Richtlinienfassung von 2021, bekommst du eine sauber belegte, veraltete Antwort – der Beleg beweist nur, dass es im Dokument steht, nicht, dass das Dokument stimmt. RAG macht Dokumentenpflege damit zur Daueraufgabe: „Wer hält die Wissensbasis aktuell?“ ist die wichtigste Projektfrage, nicht die Tool-Auswahl.
Zerteilte Dokumente antworten zerteilt. Weil Dokumente in Abschnitte zerlegt werden, kann auseinanderreißen, was zusammengehört: die Tabelle ohne ihre Fußnote, die Regel ohne die Ausnahme zwei Seiten später, der Verweis „siehe Kapitel 3″ ohne Kapitel 3. Enttäuschende Antworten liegen deshalb öfter an der Aufbereitung der Dokumente als am Modell.
RAG findet alles, was es sehen darf – auch Altlasten. Die per Frage durchsuchbare Ablage bringt jeden falsch freigegebenen Ordner ans Licht, von der alten Gehaltsliste bis zum Vertragsentwurf. Microsoft selbst mahnt, vor dem Einsatz die Berechtigungsmodelle sauber zu pflegen. Und sobald personenbezogene Daten in der Wissensbasis liegen, stellen sich die üblichen Fragen nach Rechtsgrundlage, Auskunft und Löschung – der Überblick zu KI und Datenschutz sortiert sie.
Wichtig
Vor dem Start die Ablage aufräumen: Berechtigungen prüfen, veraltete Fassungen archivieren, Verantwortliche für die Pflege benennen. RAG macht dein Wissen befragbar – deine Unordnung aber auch.
RAG, Fine-Tuning oder MCP – was brauchst du wann?
Drei Begriffe, die in Angeboten gern durcheinandergehen – dabei beantworten sie verschiedene Fragen:
| Ansatz | Was er tut | Wann er passt |
|---|---|---|
| RAG | Holt Wissen aus Dokumenten in dem Moment, in dem gefragt wird | Firmenwissen befragbar machen; Antworten mit Quellenangabe |
| Fine-Tuning | Verändert das Verhalten des Modells durch Nachtraining | Tonfall, Format, eng umrissene Spezialaufgaben – nicht für Faktenwissen: teuer, veraltet schnell, keine Quellen |
| MCP | Verbindet die KI per offenem Standard mit Systemen – Live-Daten und Aktionen | Wenn die KI in Systemen nachschauen und handeln soll: Datensatz suchen, Notiz eintragen |
Die drei schließen sich nicht aus – sie stapeln sich: Ein KI-Agent nutzt MCP-Server als Anschluss an die Systeme und RAG als Nachschlagewerk. In der Praxis beginnt trotzdem fast jedes Firmen-Projekt mit RAG, weil „Was steht in unseren Unterlagen?“ schlicht der häufigste Anwendungsfall ist.
Die Kompetenz dahinter: Wissensbasis schneiden können
RAG-Projekte scheitern selten an der Technik. Sie scheitern an Fragen, die kein Dienstleister beantworten kann: Welche Dokumente gehören in die Wissensbasis – und welche gerade nicht? Wer hält sie aktuell? Wer darf was sehen? Woran merken wir, dass die Antworten gut genug sind? Das ist keine Programmierarbeit, sondern eine Übersetzungsleistung zwischen Fachbereich und IT – und genau dafür braucht es Leute, die das Prinzip verstanden haben. Wer diese Brücke im eigenen Betrieb baut, findet den Rahmen dafür im Leitfaden KI im Unternehmen einführen.
Häufige Fragen
Was ist RAG?
RAG steht für Retrieval-Augmented Generation. Eine KI mit RAG schlägt vor jeder Antwort in einer festgelegten Wissensbasis nach – etwa deinen Firmendokumenten, übergibt die gefundenen Textstellen ans Sprachmodell und antwortet daraus, idealerweise mit Quellenangabe. Das Modell selbst bleibt dabei unverändert.
RAG oder Fine-Tuning – was brauche ich?
Für Faktenwissen fast immer RAG: aktueller, günstiger, mit Quellenangabe – und ein Dokumententausch genügt für die Aktualisierung. Fine-Tuning lohnt nur, wenn sich das Verhalten des Modells ändern soll, etwa Tonfall, Ausgabeformat oder eine eng umrissene Spezialaufgabe. Für „die KI soll unsere Dokumente kennen“ ist Fine-Tuning der falsche Weg.
Was ist der Unterschied zwischen RAG und MCP?
RAG holt Wissen: Es sucht passende Textstellen aus Dokumenten und lässt die KI daraus antworten. MCP ist ein offener Standard, der KI-Anwendungen mit Systemen wie CRM oder Datenbank verbindet – für Live-Daten und Aktionen. Vereinfacht: RAG beantwortet „Was steht in unseren Unterlagen?“, MCP ermöglicht „Schau im System nach und trag es ein“. Beides ist kombinierbar.
Verhindert RAG Halluzinationen?
Nein – es reduziert sie. Eine Stanford-Studie von 2024 fand bei kommerziellen juristischen RAG-Tools trotz Quellenbindung Fehlerquoten zwischen mehr als jeder sechsten und mehr als jeder dritten Antwort. Die Quellenangabe ist deshalb kein Ersatz fürs Prüfen, sondern das Werkzeug dafür: Fundstelle anklicken und nachlesen.
Welche fertigen RAG-Produkte gibt es für Unternehmen?
Ohne Eigenbau: NotebookLM (heute Gemini Notebook) für hochgeladene Dokumente mit klickbaren Belegstellen, Microsoft Copilot mit Anbindung an SharePoint und Microsoft Graph, und Copilot Studio als Baukasten für eigene Assistenten mit festgelegten Wissensquellen. Eigenbau mit Open-Source-Bausteinen lohnt erst bei besonderen Anforderungen wie strikter Datenhoheit.
Kann ich RAG kostenlos ausprobieren?
Ja. NotebookLM ist mit einem normalen Google-Konto kostenlos nutzbar: eigene Dokumente hochladen, Fragen stellen, Belegstellen prüfen – das ist das RAG-Prinzip in Reinform. Für Vertrauliches gilt: kein privates Konto verwenden und die Datenschutz-Hinweise des Anbieters lesen. Wer Daten komplett im Haus behalten muss, kann RAG auch lokal mit Open-Source-Werkzeugen aufsetzen.
Dein Team soll KI mit euren eigenen Daten arbeiten lassen – sicher
Wir schulen Beschäftigte praxisnah im Arbeiten mit KI: Werkzeuge wie NotebookLM und Copilot sinnvoll einsetzen, Wissensbasen sauber aufbauen, Antworten prüfen statt glauben. Für Unternehmen können die Kosten über das Qualifizierungschancengesetz gefördert werden, wenn die Voraussetzungen erfüllt sind – wir prüfen das kostenlos mit dir.
Kostenloses Erstgespräch sichern
Benedikt Backhaus – schreibt bei Scaly über KI-Tools, neue Modelle und aktuelle Entwicklungen rund um künstliche Intelligenz. Er beobachtet die KI-Szene laufend und ordnet ein, was neue Releases praktisch bedeuten – ehrlich und ohne Hype. Einschätzung, keine Rechtsberatung. Benedikt auf LinkedIn