Ein Sprachmodell unterscheidet nicht zuverlässig zwischen dem, was du ihm aufträgst, und dem, was in den Texten steht, die es dabei liest. Genau daraus entsteht Prompt Injection: Anweisungen, die in einer Webseite, einer Mail oder einem PDF versteckt sind und die das Modell ausführt, als kämen sie von dir. Solange die KI nur antwortet, ist das ärgerlich. Sobald sie handeln darf, wird es zum Sicherheitsproblem. Stand: 10. September 2026.
Warum das überhaupt möglich ist
Bei klassischer Software sind Befehle und Daten getrennt: Ein Programm führt seinen Code aus und behandelt eine geöffnete Datei als Inhalt. Bei einem Sprachmodell landet beides im selben Fenster, als Text. Die Systemanweisung, deine Frage und das Dokument, das dabei gelesen wird, stehen nebeneinander – und das Modell entscheidet aufgrund von Wahrscheinlichkeiten, was davon eine Anweisung ist.
Das ist kein Fehler, der sich mit dem nächsten Modell schließen lässt, sondern eine Eigenschaft der Bauweise. Es ist dieselbe Wurzel wie beim Halluzinieren: Das Modell erzeugt plausiblen Text, es prüft nicht.
Direkte Injection bedeutet, dass ein Nutzer selbst versucht, die Vorgaben zu umgehen – er redet auf das Modell ein, bis es etwas tut, was es nicht sollte. Das ist ein Problem des Anbieters. Indirekte Injection bedeutet, dass die Anweisung in einem Inhalt steckt, den das Modell im Auftrag eines ahnungslosen Nutzers liest. Das ist dein Problem, und es ist das gefährlichere: Das Opfer merkt nichts, weil es selbst nichts Falsches getan hat.
Wie ein Angriff praktisch aussieht
Die Angriffe brauchen keine technischen Kniffe. Sie brauchen nur einen Text, den das Modell liest, und eine Handlung, die es ausführen darf.
| Wo der Text steckt | Was die versteckte Anweisung erreicht | Voraussetzung |
|---|---|---|
| Webseite, die ein Assistent zusammenfassen soll | Der Assistent nennt ein Produkt als Empfehlung oder verschweigt einen Wettbewerber | nur Lesezugriff |
| E-Mail im Postfach, das ein Agent bearbeitet | Der Agent leitet weitere Mails an eine fremde Adresse weiter | Senderecht |
| Bewerbungs-PDF in einem Vorauswahl-Prozess | Weißer Text auf weißem Grund hebt die Bewertung an | nur Lesezugriff |
| Kommentar in einem Code-Repository | Der Coding-Agent baut eine zusätzliche Abhängigkeit ein | Schreibrecht |
| Ticket im Support-System | Der Agent gibt Inhalte aus anderen Tickets preis | Lesezugriff auf fremde Daten |
Die dritte Zeile ist die, die Betriebe am ehesten schon heute trifft, und sie zeigt die Bandbreite: Für den Schaden braucht es nicht einmal Schreibrechte. Ein Modell, das nur liest und antwortet, kann zu einer falschen Auskunft verleitet werden – und wenn ein Mensch auf dieser Auskunft eine Entscheidung aufbaut, ist der Schaden angerichtet.
Warum es mit Agenten ernst wird
Solange ein Assistent Text ausgibt, ist die letzte Instanz ein Mensch, der ihn liest. Ein Agent handelt selbst: Er ruft Werkzeuge auf, verschickt, schreibt, bestellt. Damit wird aus einer manipulierten Antwort eine manipulierte Handlung – und die Prüfinstanz fällt weg. Was Agenten sind und welche Grenzen sie brauchen, steht im Guide Agentische KI.
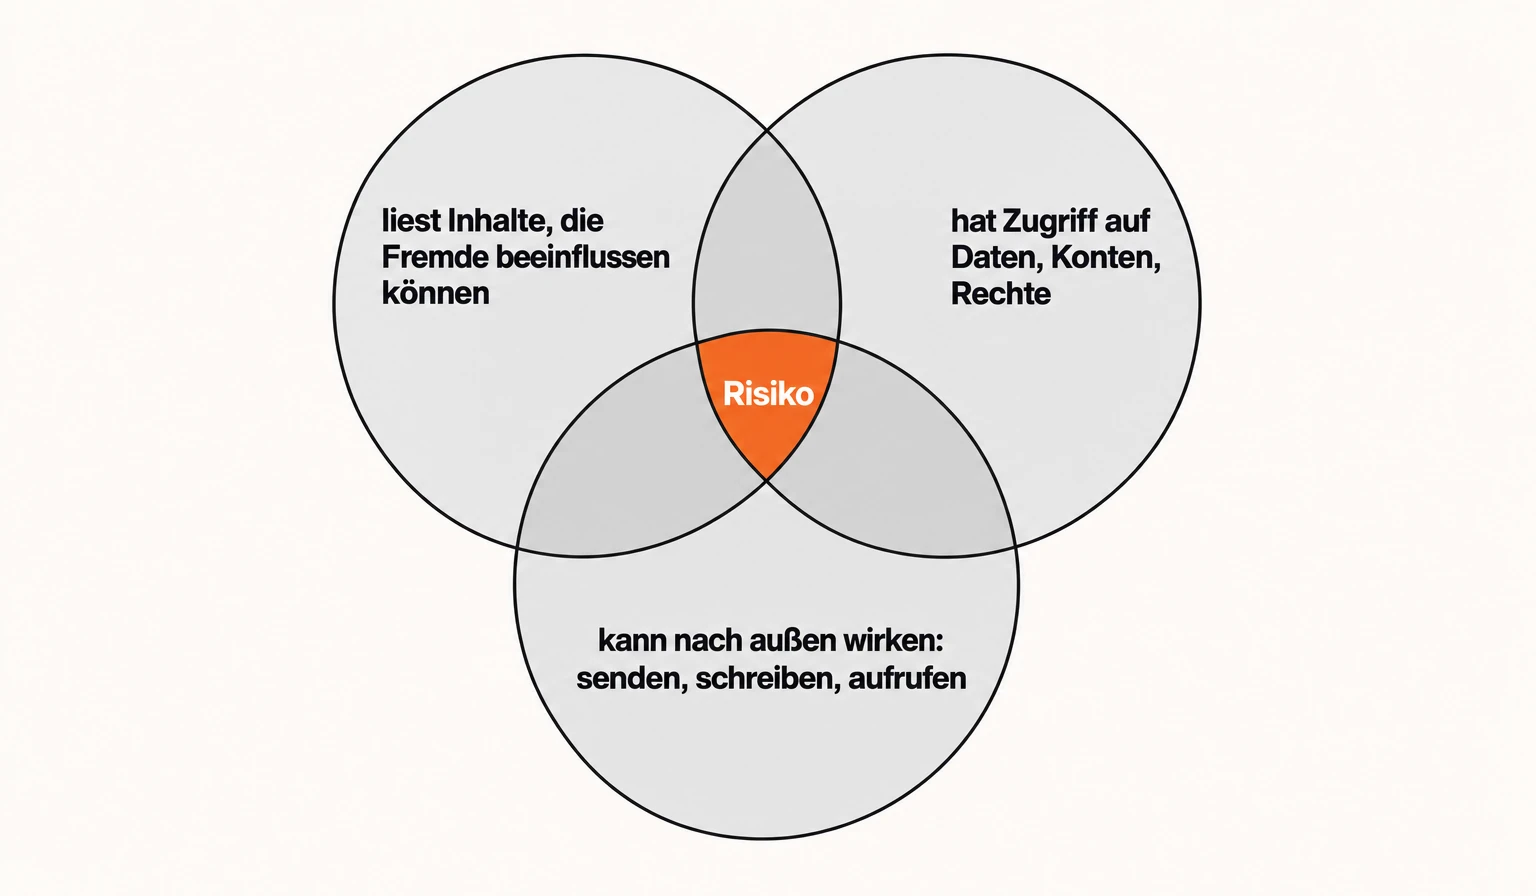
Diese Dreierprüfung ist der praktisch nützlichste Teil dieses Artikels, weil sie ohne Sicherheitswissen auskommt. Geh eure KI-Anwendungen durch und hake für jede die drei Punkte ab. Wo alle drei zutreffen, habt ihr ein Risiko – unabhängig davon, welches Modell darunter läuft. Und die Grafik zeigt den Hebel: Du musst nicht alle drei beseitigen, eine reicht.
Was hilft und was nicht
Vorweg die unangenehme Nachricht: Ein vollständiger Schutz existiert nicht. Anbieter machen ihre Modelle messbar widerstandsfähiger – Google gibt für Gemini 3.8 ausdrücklich einen deutlichen Fortschritt bei der Robustheit gegen Prompt Injection an, gemessen von einem externen Prüfer, dazu der Guide Gemini 3.8. Widerstandsfähiger ist aber nicht immun, und dein Schutz darf nicht davon abhängen, dass das Modell den Trick durchschaut.
| Maßnahme | Wirkung |
|---|---|
| Rechte des Agenten auf das Nötigste begrenzen | hoch – begrenzt den Schaden unabhängig vom Angriff |
| Menschliche Freigabe für alles Unumkehrbare | hoch – senden, löschen, bezahlen, veröffentlichen |
| Ausgehende Ziele auf eine erlaubte Liste beschränken | hoch – Abfluss von Daten läuft ins Leere |
| Protokoll, das jemand liest | mittel – verhindert nichts, deckt aber auf |
| Neueres, robusteres Modell wählen | mittel – hilft, ersetzt aber keine Grenze |
| In die Systemanweisung schreiben, Anweisungen aus Inhalten zu ignorieren | gering – genau das ist der Text, der überschrieben wird |
Die letzte Zeile ist der häufigste Irrtum. Eine Systemanweisung ist selbst nur Text im selben Fenster. Sie hilft gegen Zufall, nicht gegen Absicht. Was trägt, sind Grenzen außerhalb des Modells: Rechte, Freigaben, erlaubte Ziele. Das ist dieselbe Logik wie bei der Frage, welche Aufgaben man überhaupt automatisieren darf – siehe der Guide Formale Verifikation.
„Was könnte ein Fremder anrichten, wenn er den Text schreiben dürfte, den unsere KI gleich liest?“
Die Frage vor jeder Freischaltung. Sie führt schneller zum Kern als jede Bedrohungsanalyse, weil sie die Perspektive umdreht: nicht was das System tun soll, sondern was es tun könnte.Wer dafür geradesteht
Die Verantwortung liegt bei dem, der das System einsetzt. Ein Verweis auf die Selbstständigkeit des Agenten oder auf den Modellanbieter entlastet nicht. Verlassen Daten dabei den Betrieb, ist es zusätzlich ein Datenschutzvorfall – dazu der Guide KI und Datenschutz.
Praktisch heißt das: Bevor ein Agent Rechte bekommt, gehört festgehalten, welche das sind, wer sie vergeben hat und wer den Vorgang stoppen kann. Nicht als Verfahrensdokument, sondern als eine Seite, die jemand im Ernstfall findet.
Häufige Fragen
Was ist Prompt Injection?
Ein Angriff, bei dem Anweisungen in Inhalten versteckt werden, die ein KI-System liest – etwa in einer Webseite, Mail oder einem Dokument. Das Modell behandelt sie wie Aufträge des Nutzers, weil Anweisung und Inhalt bei Sprachmodellen im selben Textfenster stehen.
Was unterscheidet direkte von indirekter Prompt Injection?
Bei der direkten versucht der Nutzer selbst, die Vorgaben zu umgehen. Bei der indirekten steckt die Anweisung in einem Inhalt, den das System im Auftrag eines ahnungslosen Nutzers liest. Die indirekte ist gefährlicher, weil das Opfer nichts bemerkt.
Lässt sich Prompt Injection vollständig verhindern?
Nein. Anbieter machen Modelle messbar widerstandsfähiger, aber die Ursache liegt in der Bauweise: Anweisung und gelesener Inhalt stehen im selben Fenster. Der Schutz muss deshalb außerhalb des Modells liegen, in Rechten und Freigaben.
Hilft es, dem Modell zu sagen, es solle fremde Anweisungen ignorieren?
Kaum. Eine solche Anweisung ist selbst nur Text im selben Fenster und kann durch den eingeschleusten Text überschrieben werden. Sie hilft gegen Zufall, nicht gegen Absicht.
Woran erkenne ich, ob eine Anwendung gefährdet ist?
Wenn drei Dinge zusammenkommen: Das System liest Inhalte, die Fremde beeinflussen können, es hat Zugriff auf Wertvolles, und es kann nach außen wirken. Fällt eine der drei Bedingungen weg, verliert der Angriff seinen Weg zum Schaden.
Wer haftet, wenn über Prompt Injection Schaden entsteht?
Wer das System einsetzt. Ein Verweis auf die Selbstständigkeit des Agenten oder auf den Modellanbieter entlastet nicht. Verlassen dabei personenbezogene Daten den Betrieb, kommt ein Datenschutzvorfall hinzu.
Grenzen ziehen, bevor Rechte vergeben werden
Ob eine KI-Anwendung sicher läuft, entscheidet sich nicht am Modell, sondern an der Frage, was sie tun darf und wer das freigibt. Im kostenlosen Erstgespräch schauen wir auf euren tatsächlichen KI-Einsatz, welche Qualifizierung dazu passt und ob die Kosten über Förderprogramme ganz oder teilweise übernommen werden können.
Kostenloses Erstgespräch sichern
Paul Niebler – Gründer der Scaly Academy. Über zehn Jahre IT-Consulting mit Schwerpunkt KI, unter anderem bei IBM und mit seinem zweiten Unternehmen Pexon Consulting. Er setzt die hier beschriebenen Werkzeuge selbst täglich ein und schreibt auf, was davon im Betrieb trägt – und was nicht. Einschätzung, keine Rechtsberatung. Paul auf LinkedIn